هر کارخانهای که میشناسم یک گنج دارد که هیچوقت خوانده نمیشود: هزاران یادداشت کوتاه که تکنسینها در دستور کارهای تعمیرات تایپ کردهاند و صدها شکایت مشتری که بهصورت متن آزاد ثبت شده. هیچکس نمیتواند همه را بخواند، برای همین در اکسل میمانند و کسی از آنها چیزی یاد نمیگیرد. در این آموزش یک قدم اول ساده با پایتون را نشان میدهم که این یادداشتها را به یک فهرست روشن از خرابیهای تکراری تبدیل میکند، و اینکه کجا جمع کردن داده از وب هم به کار میآید.
در ۲۴ سال کار در صنعت تولید بارها دیدهام که یک خرابی روی یک دستگاه دوباره و دوباره تعمیر شده، چون هر تعمیر یک سطر متن جدا بوده که کسی آنها را به هم وصل نکرده. کمی متنکاوی اغلب ارزانترین راه برای دیدن همین الگوست. کارخانه و همهٔ عددهای این مقاله فرضی هستند و دادهٔ هیچ شرکت واقعیای نیستند.
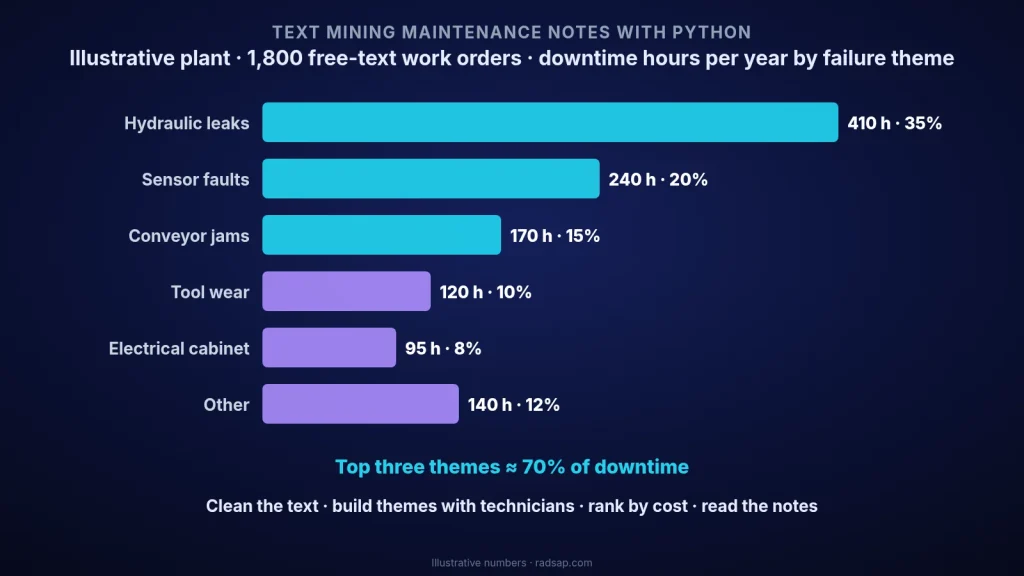
مثال فرضی
یک کارخانه حدود ۱۸۰۰ دستور کار تعمیرات از دوازده ماه گذشته دارد. هر کدام یک تاریخ، کد دستگاه، مدت توقف به دقیقه و یک یادداشت کوتاه دارد، مثل «نشتی روغن پرس ۳، کاسهنمد عوض شد» یا «دوباره نشتی هیدرولیک، کاسهنمد». مدیر نگهداری و تعمیرات حس میکند «نشتی» مشکل بزرگی است، ولی گزارش فقط توقف هر دستگاه را نشان میدهد، نه توقف هر علت را. سؤال ساده است: کدام چند نوع خرابی بیشتر توقفها را میسازند؟
قدم ۱: متن را همراه با عددهایش خروجی بگیرید
متن بهتنهایی کافی نیست. یک جدول خروجی بگیرید که در هر سطر، یادداشت متنی کنار ستونهایی باشد که به آن وزن میدهند: تاریخ، دستگاه یا محصول، دقیقهٔ توقف، هزینه یا تعداد قطعهٔ مرجوعی. یک خروجی سادهٔ اکسل یا CSV از سیستم نگهداری و تعمیرات یا دفتر ثبت شکایتها کافی است. در این مثال ۱۸۰۰ سطر و چهار ستون داریم.
قدم ۲: متن را تمیز کنید
تکنسینها تند مینویسند. یک کلمه با املای مختلف، مخفف، فاصلهٔ اضافه و در متن فارسی با شکل عربی و فارسی همان حروف تکرار میشود. چند خط پایتون با کتابخانهٔ pandas کارهای پایه را انجام میدهد:
import pandas as pd, re
df = pd.read_excel("work_orders.xlsx")  # date, machine, note, downtime_min
def clean(t):
    t = str(t).lower()
    t = t.replace("ي", "ی").replace("ك", "ک")  # Arabic to Persian letters
    t = re.sub(r"[^\w\s]", " ", t)            # drop punctuation
    return re.sub(r"\s+", " ", t).strip()
df["text"] = df["note"].map(clean)
بعد ۵۰ کلمهٔ پرتکرار را نگاه کنید. همین فهرست معمولاً بیشتر از گزارشهای ماهانهٔ یک سال حرف برای گفتن دارد.
قدم ۳: با تکنسینها یک فرهنگ کوچک از دستهها بسازید
این قدمی است که نتیجه را قابل اعتماد میکند. یک ساعت با دو تکنسین باتجربه بنشینید و کلمههای پرتکرار را در دستههای خرابی گروه کنید: «نشت»، «چکه»، «کاسهنمد» و «روغن روی زمین» همه یعنی نشتی هیدرولیک؛ «سنسور»، «پراکسیمیتی» و «سیگنال نمیدهد» یعنی خرابی سنسور. بعد هر یادداشت را با دستهاش برچسب بزنید:
themes = {
    "hydraulic leak": ["leak", "drip", "seal", "نشت"],
    "sensor fault":   ["sensor", "proximity", "no signal", "سنسور"],
    "conveyor jam":   ["jam", "stuck", "گیر"],
}
def theme(t):
    for name, words in themes.items():
        if any(w in t for w in words):
            return name
    return "other"
df["theme"] = df["text"].map(theme)
در این مثال، در بار اول حدود ۴۰٪ یادداشتها در دستهٔ «سایر» ماندند. بعد از دو جلسهٔ کوتاه با تکنسینها و اضافه کردن کلمههایی که واقعاً به کار میبرند، «سایر» به حدود ۱۲٪ رسید.
قدم ۴: دستهها را بر اساس هزینهشان رتبهبندی کنید
شمردن یادداشتها کافی نیست؛ یک توقف طولانی از ده ریاستارت سریع مهمتر است. توقف (یا هزینه، یا قطعهٔ مرجوعی) هر دسته را جمع بزنید و مرتب کنید، یعنی یک پارتوی ساده:
pareto = (df.groupby("theme")["downtime_min"].sum()
            .sort_values(ascending=False) / 60).round()
print(pareto) # downtime hours per theme| دسته | توقف (ساعت در سال) | سهم |
|---|---|---|
| نشتی هیدرولیک | ۴۱۰ | ۳۵٪ |
| خرابی سنسور | ۲۴۰ | ۲۰٪ |
| گیر کردن نوار نقاله | ۱۷۰ | ۱۵٪ |
| سایش ابزار | ۱۲۰ | ۱۰٪ |
| تابلو برق | ۹۵ | ۸٪ |
| سایر | ۱۴۰ | ۱۲٪ |
در کارخانهٔ فرضی، سه دسته حدود ۷۰٪ توقف را میسازند و بیشتر ساعتهای نشتی از کاسهنمدهای دو پرس است. این یک فهرست کوتاه و مشخص برای اقدام است، بهجای یک حس کلی که «نشتی مشکل است».
قدم ۵: یادداشتهای پشت هر دستهٔ اصلی را بخوانید
قبل از اینکه چیزی را ارائه کنید، ۲۰ تا ۳۰ یادداشت واقعی از هر کدام از دستههای اصلی را بخوانید. برچسبهای اشتباه را پیدا میکنید و اغلب داستان واقعی را هم: همان قطعهٔ کاسهنمد، همان شیفت، یا تعمیری که فقط یک وصلهٔ موقت بوده. عددها جای مشکل را نشان میدهند؛ یادداشتها میگویند آنجا چه خبر است.
همین قدمها برای شکایت مشتری هم جواب میدهد
متن شکایتهایی که از نمایندگیها، مرکز تماس یا فرمهای خدمات پس از فروش میآید هم همین مسیر را دارد: تمیز کردن، ساختن دستهها با کسانی که شکایتها را پیگیری میکنند و رتبهبندی بر اساس هزینه یا تعداد قطعهٔ مرجوعی. وصل کردن یک دستهٔ شکایت به تاریخ و خط تولید، اغلب جایی است که مفیدترین یافته پیدا میشود.
نکتهای دربارهٔ وباسکرپینگ
گاهی متنی که لازم دارید بیرون از شرکت است: فهرست قیمت تأمینکنندهها، صفحهٔ محصول رقبا یا نظرهای عمومی. پایتون میتواند اینها را خودکار جمع کند، ولی باید درست انجامش داد:
- اگر سایت API رسمی یا فایل دانلودی دارد، از همان استفاده کنید.
- قوانین سایت و فایل robots.txt را بخوانید و رعایت کنید.
- آرام پیش بروید: چند درخواست با فاصله، نه صدها درخواست در دقیقه.
- دادهٔ شخصی جمع نکنید و فقط چیزی را نگه دارید که لازم دارید.
یک اسکریپت کوچک ماهانه که قیمت ده مادهٔ اولیهٔ اصلی شما را از صفحههای عمومی تأمینکنندهها جمع کند، یک پروژهٔ اول خوب و کمریسک برای وباسکرپینگ است.
کجا کار سختتر میشود
روش کلمهٔ کلیدی که گفتم یک قدم اول قوی است و برای خیلی از کارخانهها برای شروع اقدام کافی است. کار وقتی تخصصیتر میشود که دهها هزار یادداشت دارید، متن فارسی و انگلیسی قاطی است، یا دستههایی هست که هنوز به ذهن کسی نرسیده. آنجا روشهایی مثل خوشهبندی متن، مدلسازی موضوعی یا مدلهای زبانی برای دستهبندی وارد میشوند و بخش سخت کار این میشود که درستی نتیجه را بسنجید و آن را به هزینه و به سیستمهای نگهداری و کیفیت وصل کنید. این همان کاری است که معمولاً با تیمها انجام میدهم.
اشتباههای رایج
- شمردن یادداشت بهجای هزینه. همیشه دستهها را با توقف، هزینه یا قطعهٔ مرجوعی وزن بدهید.
- ساختن فهرست دستهها بهتنهایی. بدون کلمههای خود تکنسینها، یادداشتهای زیادی در «سایر» میمانند.
- اعتماد به برچسبها بدون خواندن نمونه. بیست یادداشت واقعی برای هر دسته بیشتر خطاها را پیدا میکند.
- یک بار انجام دادن. هر ماه اجرایش کنید تا فرهنگ دستهها هر بار بهتر شود.
متنکاوی با کارهای دیگری که دربارهشان نوشتهام خوب جور میشود: تمیز کردن دادهٔ کارخانه در اکسل با Claude، پیدا کردن علت ریشهای واقعی در دادهٔ توقفات، و جستوجوی هوشمند در اسناد کارخانه که آن هم روی متنهای سازمان کار میکند.
میخواهید ببینید یادداشتهای تعمیرات یا شکایتهای مشتریتان چه میگویند؟
توضیح کوتاهی از دادهتان برایم بفرستید، مثلاً چند دستور کار یا شکایت دارید و در کدام سیستم. با هم بررسی میکنیم که یک قدم اول متنکاوی چه چیزی را نشان میدهد و رفع کدام خرابیها اولویت دارد.
تماس با من بخوانید: علت ریشهای در دادهٔ توقفات بخوانید: تمیز کردن دادهٔ کارخانه
منابع
- تمیز کردن متن، فرهنگ کلمههای کلیدی و تحلیل پارتو روی سوابق تعمیرات و شکایتها از قدمهای رایج اول در متنکاوی صنعتی است و کتابخانهٔ pandas در پایتون برای این کار زیاد استفاده میشود.
- وباسکرپینگ مسئولانه یعنی استفاده از API رسمی در صورت وجود، رعایت قوانین سایت و robots.txt، محدود کردن تعداد درخواستها و دوری از دادهٔ شخصی.
- کارخانه، یادداشتها و همهٔ عددهای این مقاله فرضی هستند.