خیلی از کارخانهها یک پلتفرم کامل نگهداری پیشبینانه میخرند، دهها سنسور نصب میکنند و بعد در سیل هشدارها غرق میشوند—یا آنقدر منتظر برنامه سراسری هوش مصنوعی میمانند که هیچوقت شروع نمیشود. در همین حال یک ماشین بحرانی مدام خراب میشود و هر توقف برنامهریزینشده بیشتر از هزینه یک پایلوت کوچک و متمرکز آب میخورد.
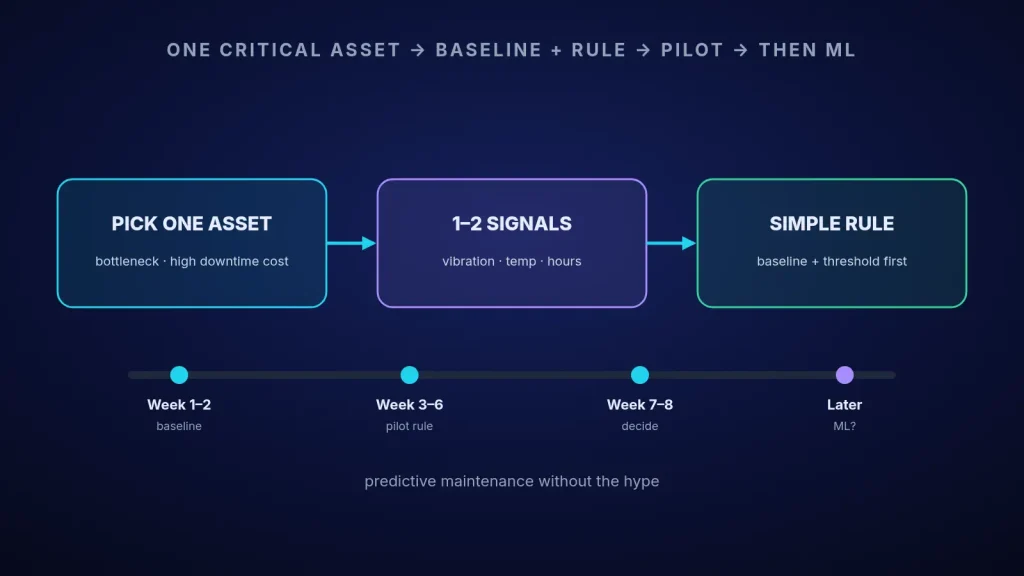
در ۲۴ سال کار در تولید و مهندسی صنایع هر دو افراط را دیدهام: داشبوردهای گرانی که کسی به آنها اعتماد ندارد، و کارخانههایی که هنوز روی نگهداری تقویمی ماندهاند در حالی که یک کمپرسور یا پرس گلوگاهی بیسر و صدا خروجی را نابود میکند. نگهداری پیشبینانه لازم نیست یعنی «هوش مصنوعی همهجا». مسیر عملی تقریباً ساده است: یک دارایی بحرانی انتخاب کنید، حالتهای خرابی واقعاً هزینهساز را تعریف کنید، یک یا دو سیگنال قابلفهم اندازه بگیرید، خط پایه و یک قاعده ساده بگذارید، و یک پایلوت کوتاه با بودجه مشخص هشدار غلط اجرا کنید.
در ادامه یک روش مشخص، یک مثال عددی با اعداد نمونه، و یک چکلیست میآید که میتوانید به جلسه بعدی نت ببرید.
ویدیوهای بیشتر در کانال یوتیوب من ↗
چرا پروژههای سراسری PdM گیر میکنند؟
استانداردهای پایش وضعیت مثل ISO 17359 از هزینه–فایده، اولویتبندی بحرانی بودن و حالتهای خرابی شروع میکنند—نه از خرید همه سنسورهای کاتالوگ. وقتی تیمها این را رد میکنند و مستقیم سراغ «PdM با هوش مصنوعی» میروند، معمولاً سه چیز خراب میشود:
- داراییهای زیاد همزمان. حجم هشدار سریعتر از توان بررسی تیم بالا میرود و افراد سیستم را بیصدا میکنند.
- سیگنال بدون خط پایه. بدون دوره کارکرد سالم مشخص، هر جهش شبیه بحران به نظر میرسد.
- یادگیری ماشین قبل از قاعده ساده. اگر روند دما یا آستانه لرزش بیشتر خرابیها را میگیرد، مدل قبل از اثبات فرایند فقط هزینه و ابهام اضافه میکند.
راهنمای بهترین اقدامات عملیات و نگهداری وزارت انرژی آمریکا نگهداری پیشبینانه را یکی از انواع برنامه میداند—وقتی بتوانید خرابی را زودتر از وقوع تشخیص دهید تا تعمیر برنامهریزی شود. دقیقاً همین معیار برای پایلوت تکدارایی کافی است.
روش عملی: یک دارایی، بعد گسترش
- یک دارایی بحرانی انتخاب کنید. ماشین گلوگاهی، نقطه تکخرابی، یا دارایی با بالاترین هزینه توقف در ساعت را ترجیح دهید. در یک جمله بنویسید چرا بحرانی است.
- حالتهای خرابی مهم را فهرست کنید. خرابیهای عجیب که هرگز ندیدهاید را کنار بگذارید. روی دو یا سه حالتی تمرکز کنید که در ۱۲ تا ۲۴ ماه گذشته توقف برنامهریزینشده ساختهاند.
- یک یا دو سیگنال قابل اندازهگیری انتخاب کنید. لرزش، دمای یاتاقان، جریان موتور، ساعت کارکرد، نرخ ضایعات یا زمان سیکل—هر چیزی که به آن حالتهای خرابی وصل باشد. سیگنالهایی را ترجیح دهید که هر شیفت پایدار جمع میشوند.
- قبل از هر یادگیری ماشین، خط پایه بسازید. دو تا چهار هفته تولید عادی را ثبت کنید و بازه معمول را بنویسید. یک آستانه هشدار یا قاعده روند ساده بگذارید (مثلاً: میانگین ۷روزه بالاتر از خط پایه بهعلاوه X٪). ISO 13374 گامهای پردازش از جمعآوری تا توصیه را توصیف میکند؛ روز اول به کل پشته نیاز ندارید—تشخیص وضعیت و یک توصیه روشن به نت کافی است.
- پایلوت ۴ تا ۸ هفته با بودجه هشدار غلط اجرا کنید. از قبل توافق کنید هفتهای چند هشدار غلط قابل قبول است. موارد درست، هشدار غلط، ساعت توقف جلوگیریشده و ساعت صرفشده برای بررسی را ثبت کنید.
- فقط بعد از آن به یادگیری ماشین فکر کنید. اگر قاعده ساده خودش هزینه را برمیگرداند، نگهش دارید. وقتی رویداد برچسبخورده، سنسور پایدار و مالک نت که روی پیشبینی عمل کند دارید، مدل اضافه کنید.
مثال عملی: یک کمپرسور هوای بحرانی (اعداد نمونه)
اعداد زیر یک مثال فرضی هستند، نه داده یک کارخانه واقعی. آنها را با اعداد خودتان جایگزین کنید.
| مورد | مقدار نمونه |
|---|---|
| دارایی | کمپرسور هوای کارخانه C-3 (گلوگاه دو خط) |
| هزینه توقف برنامهریزینشده | ۲٬۵۰۰ دلار در ساعت (خروجی ازدسترفته + اضافهکاری؛ نمونه) |
| خرابی در ۱۲ ماه گذشته | ۴ رویداد یاتاقان / داغشدن |
| میانگین ساعت ازدسترفته در هر خرابی | ۶ ساعت |
| هزینه توقف سالانه (نمونه) | ۴ × ۶ × ۲٬۵۰۰ = ۶۰٬۰۰۰ دلار |
| سیگنالهای پایلوت | لرزش سمت محرک (mm/s) + دمای پوسته یاتاقان |
| قاعده ساده (قبل از ML) | هشدار اگر دما ۲۰ دقیقه > خطپایه+۱۵°C، یا RMS لرزش > ۱٫۵× خط پایه |
| هزینه پایلوت (سنسور، ثبت، ۶ هفته پیگیری) | حدود ۴٬۰۰۰ تا ۸٬۰۰۰ دلار (بازه نمونه) |
| معیار موفقیت پایلوت | گرفتن حداقل ۲ رویداد زودتر از خرابی؛ حداکثر ۳ هشدار غلط در هفته |
| اگر فقط یک توقف ۶ساعته جلوگیری شود | حدود ۱۵٬۰۰۰ دلار صرفهجویی در برابر هزینه پایلوت |
برای بردن لازم نیست پیشبینی کامل باشد. گرفتن یک خرابی یک هفته زودتر—سفارش یاتاقان و برنامهریزی توقف برای شنبه—اغلب هزینه پایلوت را برمیگرداند. اگر بعد از هشت هفته فقط نویز دیدید، متوقف شوید: یا سیگنال برای آن حالت خرابی غلط است، یا دارایی اولین انتخاب اشتباه بوده. همان هم نتیجه مفیدی است.
بعد از پایلوت «خوب» چه شکلی است؟
- یک مالک مشخص (نت یا قابلیت اطمینان) که هر شیفت هشدارها را میبیند.
- خط پایه و آستانههای مکتوب کنار سیستم دستورکار—نه فقط داخل ابر فروشنده.
- یک لاگ کوتاه: تاریخ، سیگنال، اقدام، درست/غلط. اگر بعداً ML اضافه کنید، همین داده آموزش است.
- یک تصمیم: نگه داشتن قاعده، سختگیرانهتر کردن، عوض کردن سیگنال، یا رفتن سراغ دارایی دوم.
اگر میخواهید اولین پروژههای هوش مصنوعی را وسیعتر مقایسه کنید، مقاله کاربردهای هوش مصنوعی کاربردی در تولید نگهداری پیشبینانه را کنار کیفیت، برنامهریزی و جستوجوی اسناد میگذارد. برای واقعیت درهم فرایند قبل از نصب سنسور، فرایندکاوی از لاگ رویداد را هم ببینید. و اگر گلوگاه کتابچههای نت است نه سنسور، یک پایلوت دستیار اسناد (RAG) ممکن است بیشتر از یک داشبورد دیگر وقت آزاد کند.
چکلیست: پایلوت نگهداری پیشبینانه تکدارایی
- یک دارایی بحرانی نامگذاریشده، با برآورد هزینه توقف در ساعت.
- دو یا سه حالت خرابی که اخیراً واقعاً رخ داده.
- یک یا دو سیگنال وصلشده به آن حالتها؛ مسیر جمعآوری توافقشده.
- خط پایه از تولید عادی؛ آستانه یا قاعده روند ساده مکتوب.
- بودجه هشدار غلط و معیار موفقیت با عملیات و نت توافقشده.
- اجرای ۴ تا ۸ هفته با مالک بررسی روزانه/شیفتی.
- ثبت موارد درست، هشدار غلط و اقدامها—قبل از هر بحث ML.
- تصمیم ادامه / توقف برای گسترش یا خاتمه.
میخواهید محدوده اولین دارایی را با هم مشخص کنیم؟
اگر ماشین گلوگاهی دارید که مدام شما را غافلگیر میکند، یا پلتفرم PdM پر از هشداری که کسی به آن اعتماد ندارد، خوشحال میشوم کمک کنم اولین دارایی را انتخاب کنید، خط پایه و بودجه هشدار غلط را تعریف کنید، و پایلوت کوتاهی طراحی کنید که عملیات واقعاً دنبال کند.
تماس با من بخوانید: کاربردهای هوش مصنوعی در تولید بخوانید: از آشوب اکسل تا داشبورد زنده