تقریباً در هر شرکتی یک نمودار فرایند روی دیوار هست: سفارش میآید، تأیید میشود، به تولید میرود، ارسال میشود و فاکتور صادر میشود. جعبههای مرتب و فلشهای صاف. بعد میپرسید چرا بعضی سفارشها سه روزه تمام میشوند و بعضی سه هفته طول میکشند، و کسی جواب دقیقی ندارد. فرایند واقعی جای دیگری است: در زمانهایی که ERP و سیستمهای دیگر شما هر روز ثبت میکنند. فرایندکاوی (Process Mining) راه خواندن همین دادههاست.
در ۲۴ سال کار در صنعت، بخش بزرگی از کارم ترسیم و تحلیل فرایندها بوده و صادقانه بگویم: نقشههایی که در جلسهها میکشیدیم همیشه کمی بیش از حد مرتب بودند. آدمها فرایند را همانطور که باید باشد توصیف میکنند، نه همانطور که اتفاق میافتد. فرایندکاوی این گفتوگو را عوض میکند، چون از دادهای شروع میکند که از قبل وجود دارد، نه از نظر افراد.
در این مقاله توضیح میدهم فرایندکاوی واقعاً چیست، یک مثال کوچک با یک لاگ رویداد را قدمبهقدم مرور میکنم که میتوانید در اکسل هم بسازید، و یک راه عملی برای اجرای اولین پایلوت روی یک فرایند پیشنهاد میدهم.
فرایندکاوی واقعاً چیست؟
فرایندکاوی رشتهای است که عمدتاً با کارهای ویل فن در آلست (Wil van der Aalst) شکل گرفته و در «مانیفست فرایندکاوی» کارگروه IEEE تعریف شده است. این روش از لاگ رویداد برای کشف، بررسی و بهبود فرایندهای واقعی استفاده میکند. لاگ رویداد برای هر مرحله فقط سه چیز لازم دارد:
- شناسه پرونده (Case ID): این مرحله مربوط به کدام سفارش، فاکتور یا دستور کار است.
- فعالیت: چه اتفاقی افتاده، مثلاً «ثبت سفارش» یا «بررسی اعتبار».
- زمان: چه وقت اتفاق افتاده است.
اگر منبع (چه کسی یا کدام واحد آن را انجام داده) را هم دارید، اضافه کنید. با همین چند ستون، ابزار فرایندکاوی فرایند را همانطور که واقعاً اجرا شده رسم میکند، همه مسیرها (که به آنها واریانت میگویند) را میشمارد و نشان میدهد زمان کجا هدر میرود. مانیفست سه کاربرد اصلی را شرح میدهد: کشف (رسم فرایند واقعی)، بررسی انطباق (مقایسه با فرایند مطلوب) و بهبود (افزودن زمان، هزینه و گلوگاهها به نقشه).
مثال عملی: خواندن یک فرایند سفارش تا وصول از روی لاگ رویداد
این یک لاگ رویداد کوچک برای سه سفارش مشتری است. دادهها فقط مثال هستند و مربوط به هیچ شرکت واقعی نیستند.
| شناسه پرونده | فعالیت | زمان |
|---|---|---|
| SO-101 | ثبت سفارش | ۲ مارس، ۰۹:۱۰ |
| SO-101 | بررسی اعتبار | ۲ مارس، ۱۱:۴۰ |
| SO-101 | ارسال | ۴ مارس، ۱۵:۰۰ |
| SO-101 | صدور فاکتور | ۵ مارس، ۱۰:۰۰ |
| SO-102 | ثبت سفارش | ۲ مارس، ۱۰:۰۰ |
| SO-102 | بررسی اعتبار | ۳ مارس، ۰۹:۰۰ |
| SO-102 | تغییر قیمت | ۶ مارس، ۱۴:۰۰ |
| SO-102 | بررسی اعتبار | ۹ مارس، ۱۰:۳۰ |
| SO-102 | ارسال | ۱۳ مارس، ۱۶:۰۰ |
| SO-102 | صدور فاکتور | ۱۶ مارس، ۰۹:۰۰ |
| SO-103 | ثبت سفارش | ۳ مارس، ۰۸:۳۰ |
| SO-103 | بررسی اعتبار | ۳ مارس، ۱۰:۰۰ |
| SO-103 | ارسال | ۵ مارس، ۱۲:۰۰ |
| SO-103 | صدور فاکتور | ۶ مارس، ۰۹:۳۰ |
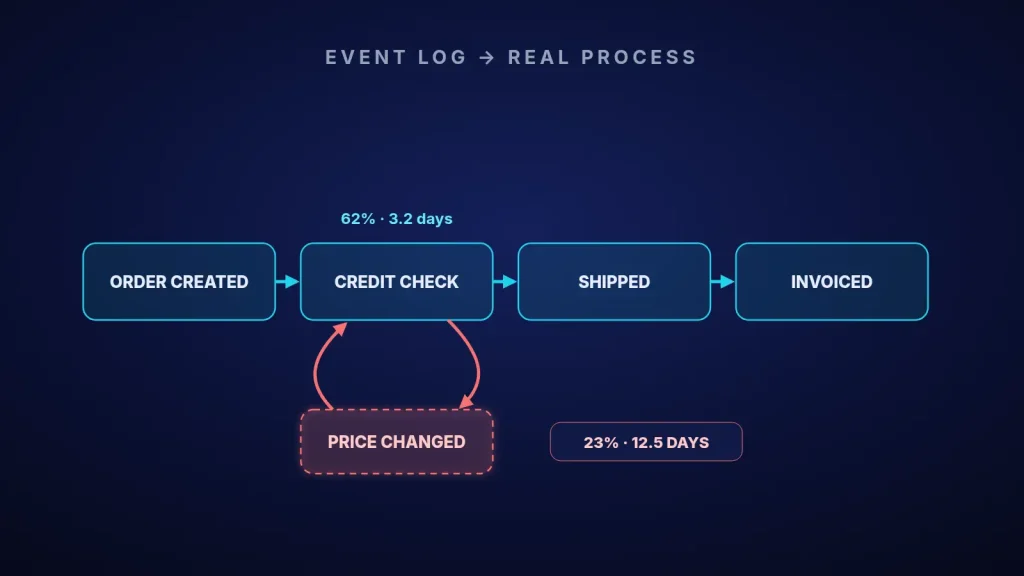
همین سه پرونده هم الگو را نشان میدهند. SO-101 و SO-103 از «مسیر ایدهآل» میروند و حدود سه روزه فاکتور میشوند. در SO-102 بعد از بررسی اعتبار، قیمت تغییر کرده و همین باعث بررسی اعتبار دوباره شده است؛ این سفارش ۱۴ روز طول کشیده. حالا مقیاس را بزرگ کنیم. فرض کنید، بهعنوان مثال، لاگ یک سال کامل ۴٬۰۰۰ سفارش دارد و این را نشان میدهد:
| واریانت (مثال) | سهم از سفارشها | میانگین سفارش تا فاکتور |
|---|---|---|
| مسیر ایدهآل: ثبت ← بررسی اعتبار ← ارسال ← فاکتور | ۶۲٪ | ۳٫۲ روز |
| تغییر قیمت ← بررسی اعتبار دوباره | ۲۳٪ | ۱۲٫۵ روز |
| واریانتهای دیگر (ارسال چندمرحلهای، توقف دستی و…) | ۱۵٪ | ۸٫۰ روز |
میانگین وزنی: ۰٫۶۲ × ۳٫۲ + ۰٫۲۳ × ۱۲٫۵ + ۰٫۱۵ × ۸٫۰ ≈ ۶٫۰ روز. اگر بیشتر حلقه تغییر قیمت را حذف کنید، مثلاً سهم این واریانت را از ۲۳٪ به ۵٪ برسانید (و بقیه به مسیر ایدهآل بروند)، میانگین به حدود ۰٫۸۰ × ۳٫۲ + ۰٫۰۵ × ۱۲٫۵ + ۰٫۱۵ × ۸٫۰ ≈ ۴٫۴ روز میرسد. یعنی برای هر سفارش حدود ۱٫۶ روز وصول سریعتر، بدون سیستم جدید، فقط با رفع ریشه تغییرهای دیرهنگام قیمت (مثلاً توافق قیمت پیش از ثبت سفارش). برای شرکتی که فرضاً سالانه ۵۰ میلیارد تومان فاکتور صادر میکند، ۱٫۶ روز کمتر یعنی حدود ۵۰ میلیارد × ۱٫۶ ÷ ۳۶۵ ≈ ۲۱۹ میلیون تومان نقدینگی که یک بار از سرمایه در گردش آزاد میشود. باز هم تأکید میکنم این اعداد مثال هستند؛ مهم روش است.
اجرای اولین پایلوت، قدمبهقدم
- قدم ۱ – یک فرایند و یک سؤال. سفارش تا وصول، خرید تا پرداخت یا اجرای دستور کار شروعهای خوبی هستند. فقط یک سؤال بپرسید، مثلاً «چرا بعضی سفارشها سه برابر بیشتر طول میکشند؟»
- قدم ۲ – استخراج لاگ رویداد. بیشتر سیستمهای ERP تغییر وضعیتها یا تاریخ اسناد را با زمان ذخیره میکنند. شناسه پرونده، فعالیت، زمان و در صورت امکان منبع را برای ۶ تا ۱۲ ماه خروجی بگیرید.
- قدم ۳ – پاکسازی. منطقههای زمانی را اصلاح کنید، رکوردهای آزمایشی را کنار بگذارید و نام فعالیتها را یکدست کنید. به تجربه من این قدم بیشترین زمان را میگیرد، پس برایش وقت بگذارید.
- قدم ۴ – کشف فرایند. لاگ را در یک ابزار بارگذاری کنید. کتابخانه متنباز PM4Py برای پایتون یا یک ابزار رایگان دانشگاهی برای پایلوت کافی است؛ پلتفرمهای تجاری بعد از اثبات ارزش میآیند.
- قدم ۵ – پیدا کردن دو سه واریانت اصلی و حلقهها. دنبال دوبارهکاری (فعالیتهایی که تکرار میشوند)، انتظارهای طولانی بین مراحل و مسیرهایی باشید که کنترلهای لازم را دور میزنند.
- قدم ۶ – سراغ آدمها بروید. داده نشان میدهد کجا؛ کسانی که کار را انجام میدهند توضیح میدهند چرا. بعد روی یک تغییر توافق کنید و یک ماه بعد دوباره اندازه بگیرید.
دستاورد
بزرگترین تغییری که از فرایندکاوی انتظار دارم این است که بحثهای بیپایان درباره فرایند زود تمام میشود. بهجای «به نظرم تأییدها کند است»، دقیقاً میبینید کدام مرحله، چقدر و در چند درصد پروندهها منتظر میماند. پروژههای بهبود کوچکتر و هدفمندتر میشوند و بعد از اجرا هم میتوانید با تکرار همان تحلیل ثابت کنید نتیجه دادهاند یا نه. این روش با کارهای دیگر هم بهطور طبیعی جفت میشود: یک داشبورد زنده عملیات میتواند واریانتهای مهم را پایش کند، نقشه قابلیتها نشان میدهد لاگها در کدام سیستمها هستند، و تأخیرهایی که پیدا میکنید اغلب همان جاهایی هستند که گلوگاه پنهان شده است.
چکلیست اولین پایلوت فرایندکاوی
- یک فرایند با دردی روشن و قابل اندازهگیری انتخاب کنید (زمان چرخه، دوبارهکاری، وصول دیرهنگام).
- یک سؤال کسبوکاری که پایلوت باید جواب دهد را بنویسید.
- مطمئن شوید ERP یا سیستم دیگر برای مراحل کلیدی زمان ثبت میکند.
- شناسه پرونده، فعالیت، زمان و منبع را برای ۶ تا ۱۲ ماه خروجی بگیرید.
- پیش از تحلیل، نام فعالیتها و منطقههای زمانی را اصلاح کنید.
- واریانتهای اصلی، حلقهها و طولانیترین انتظارها را مشخص کنید.
- یافتهها را با کسانی که فرایند را اجرا میکنند اعتبارسنجی کنید.
- روی یک تغییر توافق کنید و یک ماه بعد تحلیل را تکرار کنید.
میخواهید ببینید فرایند شما واقعاً چطور اجرا میشود؟
اگر فرایندی دارید که بعضی پروندههایش سریع رد میشوند و بعضی هفتهها گیر میکنند، خوشحال میشوم کمک کنم. میتوانیم با هم لاگ رویداد را از سیستم شما استخراج کنیم، فرایند واقعی را کشف کنیم و یافتهها را به یکی دو تغییر عملی و قابل اندازهگیری تبدیل کنیم.
تماس با من بخوانید: نقش معماری سازمانی
منابع
- IEEE Task Force on Process Mining. Process Mining Manifesto (2011): تعریف لاگ رویداد، کشف، بررسی انطباق و بهبود.
- Wil van der Aalst. Process Mining: Data Science in Action, 2nd edition, Springer, 2016.
- Fraunhofer FIT. PM4Py، کتابخانه متنباز فرایندکاوی برای پایتون.